日本のAIトレーニングデータセット市場は、2025年に1億3,370万米ドルと評価されました。同市場は2026年から2036年にかけて年平均成長率(CAGR)25.8%で拡大すると予測されており、2036年末までに市場規模は15億7,520万米ドルを超えると見込まれています。
無料のサンプルレポートをリクエストする@ https://www.surveyreports.jp/sample-request-1038299
生成AIが高品質データへの需要を拡大
日本は、経済産業省(METI)とNEDOが運営するGENIAC(Generative AI Accelerator Challenge)プログラムを通じて、国内の生成AI能力を強化しています。
2026年6月、METIとNEDOはGENIAC第4期において、AI基盤モデル開発向けの計算資源を提供する16件の新規プロジェクトを採択しました。
同時に、日本ではこうしたモデルの開発に必要なデータにも、より大きな重点が置かれています。METIとNEDOによると、公開されているウェブデータはモデルのトレーニングにおいてますます利用されるようになっており、今後のAI開発では、企業や組織が保有する実データの活用がより重要になっています。
これにより、以下の要素がより強化された商用利用可能なデータセットへの需要が生まれています。
- データ品質
- ドメインとの関連性
- アノテーション精度
- メタデータ
- データの出所
- ライセンス
- プライバシー管理
- バイアス管理
- バージョン管理
日本のデータエコシステム戦略が新たな機会を創出
2026年の主要な動きの一つは、日本が体系的なAIデータエコシステムの構築に向けて動き始めていることです。
2026年7月、METIとNEDOは、データエコシステムの構築を対象とする新たなGENIAC研究開発テーマを採択しました。このプログラムでは、複数企業が保有するデータをデータ保有者とAI開発者が適切に集約・活用できる仕組みを支援しており、新たなデータセットの構築・拡充も対象となっています。支援対象プロジェクトは2026~2028年度に実施され、個々のプロジェクトは最長2年間の支援を受けることができます。
これはAIトレーニングデータセット市場にとって重要です。市場機会が単にデータセットを販売することから、以下のインフラ構築へと移行するためです。
データ保有者 → データキュレーション → データガバナンス → データセット構築 → AI開発者 → モデル学習 → AIアプリケーション
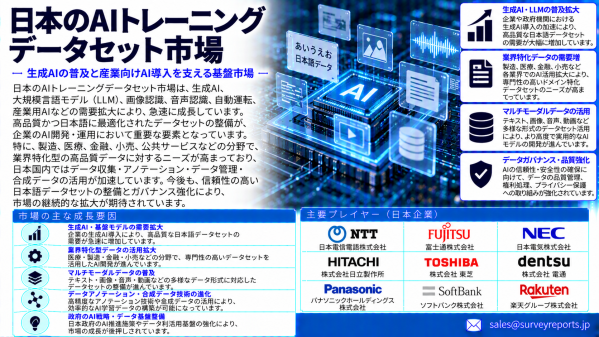
画像・動画データセット
画像・動画は、日本における大きな商業機会となっています。
需要を支える主な分野は以下のとおりです。
- コンピュータビジョン
- 自動運転
- ロボティクス
- 製造業の検査
- 医療画像
- 小売分析
- セキュリティ用途
- 農業
- スマートシティシステム
日本の産業基盤は、実際の製造環境、日本製品、機械、職場環境などを含む専門データセットに機会を提供しています。
テキストおよび日本語データセット
日本語データセットは、現地の言語、文化、ビジネス用語、制度・組織上の文脈を理解するAIシステムの開発において戦略的に重要です。
データセットの候補には以下が含まれます。
- 日本語テキストコーパス
- ビジネス文書
- 技術マニュアル
- 法務文書
- カスタマーサービスの会話データ
- 政府文書
- 学術出版物
- 日本語音声
- 専門分野別用語
- 指示追従型データセット
これらのデータセットは、単に公開アクセス可能な資料から収集するのではなく、慎重にキュレーション、ライセンス取得、アノテーションを行うことで、その価値が高まります。
マルチモーダルデータセットの重要性が高まる
AIモデルは、テキスト、画像、音声、動画を組み合わせて理解することがますます求められています。
マルチモーダルデータセットは、以下を結び付けることができます。
テキスト + 画像 + 音声 + 動画 + センサーデータ + メタデータ
日本では、これにより以下のような用途に機会が生まれます。
- ロボティクス
- 自動車AI
- 産業検査
- ヘルスケア
- 小売
- スマートファクトリー
- 自律システム
- フィジカルAI
GENIACが基盤モデルとロボティクスに継続的に注力していることは、こうしたより複雑なAIデータ能力の開発を支援する政策レベルのシグナルとなっています。
データアノテーション・ラベリング市場
多くの教師ありAIや専門AI用途では、適切なラベル付けが行われていない生データの価値は限定的です。
そのため、データセットのエコシステムには以下が含まれます。
- 画像アノテーション
- 動画アノテーション
- テキスト分類
- エンティティラベリング
- 音声文字起こし
- 感情アノテーション
- 物体検出
- セマンティックセグメンテーション
- 3D点群ラベリング
- 人間の嗜好データ
- 指示チューニング
- 強化学習用フィードバック
日本語および業界固有のアノテーションは、専門的な言語知識や技術知識が必要となるため、より高い価値を持つ可能性があります。
合成データが新たな成長領域を創出
実世界のデータが高コストであったり、取得が困難であったり、プライバシーや機密性に関する制約を受けたりする場合、合成データの重要性がますます高まっています。
想定される用途には以下があります。
- 自動運転
- ロボティクス
- 製造業
- ヘルスケア
- コンピュータビジョン
- 稀な事象のシミュレーション
- 安全性試験
合成データセットは、制御されたバリエーションやエッジケースを生成することで、実データセットを補完できます。
これは、実世界のラベル付きデータを大量に取得することが高コストとなる日本のロボティクスおよび製造業分野に特に関連性があります。
データ品質が競争上の差別化要因に
汎用データセットの供給が拡大するにつれ、データ品質の重要性がますます高まっています。
重要な品質指標には以下があります。
- 正確性
- 完全性
- 多様性
- 一貫性
- 代表性
- ラベル品質
- 重複管理
- バイアス
- 最新性
- ドメイン特異性
基盤モデルの開発者にとって、品質が低いデータや適切にフィルタリングされていないデータは、モデルの挙動に誤りをもたらす可能性があります。
そのため、データクリーニング、重複排除、品質保証ソフトウェアは重要な隣接市場となっています。
データの出所とライセンス管理
商用AI開発では、トレーニングデータがどこから取得されたのか、また法的にどのように利用できるのかを把握することの重要性が高まっています。
データセットプロバイダーには、以下のようなシステムがますます求められています。
- ソース追跡
- ライセンス管理
- 同意管理
- 著作権文書管理
- データリネージ
- 利用制限管理
- バージョン管理
- 監査可能性
これにより、データセットマーケットプレイスやデータキュレーション企業と連携して機能するAIデータガバナンスプラットフォームに新たな機会が生まれています。
プライバシー保護型データセット開発
医療、金融、雇用、顧客データは価値の高いAIトレーニング情報を提供できますが、機密情報を含む可能性があります。
そのため、組織にはプライバシーリスクを低減しながらAI開発を可能にするアプローチが必要となります。
考えられる技術には以下があります。
- データ匿名化
- 仮名化
- 合成データ
- フェデレーテッドラーニング
- プライバシー保護型分析
- セキュアデータ環境
- アクセス制御システム
日本の企業中心のAIエコシステムにおいて、これらの技術は、組織内部に隔離されたままとなる可能性のあるデータセットの活用を促進できます。
リサーチレポートはこちら@ https://www.surveyreports.jp/industry-analysis/japan-ai-training-datasets-market/1038299
政府データが新たな機会を創出
日本のデジタル庁も政府におけるAI活用の拡大に取り組んでいます。2026年度には、約18万人の府省庁職員が生成AIを利用できるようになることが見込まれており、同庁は国内LLMの開発や政府共通データセットの整備も推進しています。
これにより、以下のような機会が生まれる可能性があります。
- 政府向け言語データセット
- 公共部門文書データセット
- 行政データセット
- 日本語の法務・規制関連データセット
- 政府AI評価用データセット
- 公共サービス向け対話データセット
デジタル庁の高度AIアドバイザリー・プロセスも2026年9月まで継続しており、政府におけるAI活用をめぐる制度的な整備が継続していることを示しています。デジタル庁
AIトレーニングデータセット・インフラ
市場はデータセットの構築からインフラ領域へと拡大しています。
重要な技術には以下があります。
- データセット管理プラットフォーム
- データラベリングプラットフォーム
- データバージョニング
- データカタログ
- データマーケットプレイス
- アノテーションツール
- データ品質管理システム
- データセット評価
- データリネージプラットフォーム
- セキュアなデータ共有環境
- AI対応データパイプライン
これにより、企業はデータセットそのものと、データセットの準備、管理、配布に必要なインフラの両方から収益を得られるエコシステムが形成されています。
主要なデータセットタイプ
テキストデータセット
LLMのトレーニングや自然言語アプリケーション向けの日本語および専門分野別テキスト。
画像・動画データセット
ロボティクス、自動車、製造業などの用途向けコンピュータビジョンデータセット。
音声・スピーチデータセット
日本語音声認識、音声アシスタント、コールセンターAI、対話型AI向けデータ。
マルチモーダルデータセット
基盤モデル向けに統合されたテキスト、画像、音声、動画、センサー情報。
産業データセット
産業AI向けの機械、生産、品質、保全情報。
ロボティクスデータセット
ロボット基盤モデル向けの実世界とのインタラクション、動作、センサーデータ。
合成データセット
稀な事象、シミュレーション、プライバシーに配慮が必要な用途向けに人工的に生成されたデータ。
主なビジネス機会
1. 業界特化型データセットプラットフォーム
自動車、製造業、ヘルスケア、金融、ロボティクスなど、日本の各業界に特化したデータセットは、汎用データよりも高い価値を持つ可能性があります。
2. 日本語データ
高品質な日本語データセットは、国内LLMを支援し、日本のビジネス環境におけるAI性能を向上させることができます。
3. 製造データエコシステム
企業は、製造データの保有者とAI開発者を安全に接続するプラットフォームを構築できます。
4. ロボティクス向けトレーニングデータ
日本がフィジカルAIを発展させる中、ロボットのデモンストレーション、センサーデータ、物理的インタラクションのデータセットは成長機会となっています。
5. データアノテーションサービス
専門的な人手およびAI支援によるアノテーションは、継続的な収益機会を創出できます。
6. 合成データ
合成データは、不足している、または機密性の高い実世界データセットを補完できます。
7. データガバナンス
データの出所、ライセンス、プライバシー、品質管理のためのツールは、ますます重要になっています。
競争環境
日本のAIトレーニングデータセットのエコシステムには、AI開発者、データサービス企業、テクノロジーベンダー、研究機関、独自の産業データを保有する組織などが含まれます。
市場は、GENIACエコシステムの影響をますます受けています。2026年9月時点で、GENIACには1,400社・団体以上が参加しています。
競争上の差別化は、以下の要素によって決まる可能性があります。
- データセットの独自性
- データ品質
- 日本語に関する専門性
- 業界特化
- アノテーション品質
- ライセンスの明確性
- データの出所
- プライバシー保護
- データセットのスケーラビリティ
- AI対応性
- モデル開発プラットフォームとの統合
最も価値の高いサプライヤーとなる可能性が高いのは、アクセスが困難な企業・産業情報を構造化されたAI対応の商用データセットへと変換できる企業です。
日本AIトレーニングデータセット市場の展望
日本のAIトレーニングデータセット市場は、比較的限定されたデータラベリングの機会から、データセットの構築、キュレーション、アノテーション、ガバナンス、ライセンス、合成データ、セキュアなデータ共有までを包含する、より広範なAIデータエコシステムへと移行しています。
最大の構造的な機会は、日本が独自データおよび業界特化型データへと移行していることから生まれています。METIは、公開されているウェブデータがAIトレーニングにますます利用されるようになるにつれて、企業や組織が保有する実データの重要性が高まると明確に述べています。
GENIACの2026年の取り組みも、データエコシステム、AI対応型製造データ、ロボティクス基盤モデルを支援することで、この方向性を強化しています。経済産業省
日本のテクノロジー企業、データ保有者、AI開発者、投資家にとって、最も価値の高い機会は、日本語データセット、産業データ、マルチモーダルデータセット、ロボティクスデータ、合成データ、信頼性の高いデータガバナンス・インフラの周辺で生まれる可能性が高いでしょう。